☞ RocketMQ 是什么
官方点说,RocketMQ 是一个统一的消息引擎、一个轻量级的数据处理平台
通俗点说,RocketMQ 是一个 队列模型 的消息中间件,具有高性能、高可靠、高实时、分布式 的特点
☞ RocketMQ 的特性
- 订阅与发布
- 消息顺序
- 消息过滤
- 消息可靠性
- 回溯消费
- 事务消息
- 定时消息
- 消息重试
- 消息重投
- 流量控制
- 死信队列
☞ RocketMQ 的模型
主题模型
在主题模型中,消息的生产者称为 发布者(Publisher) ,消息的消费者称为 订阅者(Subscriber) ,存放消息的容器称为 主题(Topic) ,发布者将消息发送到指定主题中,订阅者需要 提前订阅主题 才能接受特定主题的消息,通常的主题模型如下图:

RocketMQ 的主题模型

-
Producer Group
生产者组,例如多个订单系统作为生产者,合在一起就是一个组 ,一般生产相同的消息
-
Topic
代表一类消息,例如订单消息等
-
Consumer Group
消费者组,例如多个短信系统作为消费者,合在一起就是一个组 ,一般消费相同的消息
生产者组中的生产者会向主题发送消息,而主题中存在多个队列,生产者每次生产消息之后是指定主题中的某个队列发送消息
每个主题中都有多个队列,集群消费模式下,一个消费者集群多台机器共同消费一个 Topic 的多个队列,一个队列只会被一个消费者消费。如果某个消费者挂掉,分组内其它消费者会接替挂掉的消费者继续消费。就像上图中 Consumer1 和 Consumer2 分别对应着两个队列,而 Consuer3 是没有队列对应的,所以一般来讲要控制消费者组中的消费者个数和主题中队列个数相同 ,当然也可以消费者个数小于队列个数,只不过不太建议
每个消费组在每个队列上都需要维护一个消费位置(offset)
发布订阅模式中一般会涉及到多个消费者组,而每个消费者组在每个队列中的消费位置都是不同的,同一个消息被 A 消费组消费完后还会被 B 消费组消费,所以消息是不会删除的,仅仅是为每个消费者组维护一个 消费位移(offset) ,每次消费者组消费完以后队列把维护的消费位移 +1,这样就不会出现消息重复消费

为什么一个主题中需要维护多个队列
提高并发能力。按道理来说每个主题中只存在一个队列也是可行的,如果每个主题中只存在一个队列,这个队列中也维护着每个消费者组的消费位置,其实也可以做到发布订阅模式 ,但生产者只能向一个队列发送消息,一个消费者组中只能有一个消费者在消费,并发能力很小
所以 RocketMQ 通过使用在一个 Topic 中配置多个队列并且每个队列维护每个消费者组的消费位置实现了发布订阅模式
☞ RocketMQ 的架构
四大角色:Broker 、NameServer 、Producer 、Consumer
-
Broker
消息队列服务器,主要负责消息的存储、投递和查询以及服务高可用保证,生产者生产消息到
Broker,消费者从Broker拉取消息并消费。Broker在实际部署过程中对应一台服务器Broker 、Topic 和队列的关系
一个
Topic可以分布在多个Broker上,一个Broker可以配置多个Topic,多对多的关系如果某个
Topic消息量很大,可以多配置几个队列,提高并发能力,并且 尽量多分布在不同Broker上,以减轻某个Broker的压力 ,Topic消息量都比较均匀的情况下,如果某个Broker上的队列越多,则该Broker压力越大
Broker 的子模块
-
Remoting Module
整个 Broker 的实体,负责处理来自 Clients 端的请求
-
Client Manager
负责管理客户端(Producer / Consumer)和维护 Consumer 的 Topic 订阅信息
-
Store Service
提供方便简单的 API 接口处理消息存储到物理硬盘和查询功能
-
HA Service
高可用服务,提供 Master Broker 和 Slave Broker 之间的数据同步功能
-
Index Service
根据特定的 Message key 对投递到 Broker 的消息进行索引,以提供消息的快速查询

-
-
NameServer
注册中心,负责 Broker 管理和路由信息管理,
Broker会将自己的信息注册到NameServer中,生产者或消费者能够查找各主题相应的BrokerIP 列表,多个NameServer实例组成集群,但相互独立,没有信息交换 -
Producer
生产者把消息发送到
Broker服务器,支持分布式集群方式部署。RocketMQ 提供多种发送方式:同步发送、异步发送、顺序发送、单向发送,同步和异步方式均需要
Broker返回确认信息,单向发送不需要 -
Consumer
消费者会从
Broker服务器拉取消息,支持分布式集群方式部署。从用户应用的角度而言提供了两种消费形式:拉取式消费(Pull)、推动式消费(Push)
Push:Broker 收到数据后会主动推送给消费端,该消费模式一般实时性较高
Pull:应用通常主动调用 Consumer 的拉消息方法从 Broker 服务器拉消息、主动权由应用控制。一旦获取了批量消息,应用就会启动消费过程
RocketMQ 支持两种消息模式:集群消费(Clustering)、广播消费(Broadcasting)
Clustering:相同 Consumer Group 的每个 Consumer 实例平均分摊消息
Broadcasting:相同 Consumer Group 的每个 Consumer 实例都接收全量的消息
四者关系图如下

Broker 是需要保证高可用的,如果整个系统仅仅靠着一个 Broker 来维持的话,那么这个 Broker 的压力会很大,所以我们需要使用多个 Broker 来保证 负载均衡
如果说,我们的消费者和生产者直接和多个 Broker 相连,那么当 Broker 修改的时候必定会牵连着每个生产者和消费者,这样就会产生耦合问题,而 NameServer 注册中心就是用来解决这个问题的
☞ RocketMQ 的存储机制
队列是以什么样的形式存在的?队列中的消息又是如何进行存储持久化的?
RocketMQ 消息存储架构
-
CommitLog
消息主体以及元数据的存储主体,存储
Producer端写入的消息主体内容,消息内容不是定长的。单个文件大小默认 1GB ,文件名长度为 20 位,左边补零,剩余为起始偏移量,比如 00000000000000000000 代表了第一个文件,起始偏移量为0,文件大小为 1GB = 1073741824B;当第一个文件写满了,第二个文件为 00000000001073741824,起始偏移量为 1073741824,以此类推。消息是顺序写入日志文件,当文件满了,写入下一个文件CommitLog文件要设计成固定大小的长度是因为RocketMQ采用了FileChannel和DirectBuffer的方式来映射文件,DirectBuffer 会少一次内存拷贝,使用堆外内存,降低 GC 的频率 -
ConsumeQueue
消息消费队列,引入的目的主要是提高消息消费的性能,由于
RocketMQ是基于主题Topic的订阅模式进行消息消费,如果要遍历CommitLog文件中根据Topic检索消息非常低效。Consumer即可根据ConsumeQueue来查找待消费的消息。ConsumeQueue作为消费消息的索引,保存了指定Topic下的队列消息在CommitLog中的起始物理偏移量offset、消息大小size、消息Tag的HashCode值。ConsumeQueue文件可以看成是基于Topic的CommitLog索引文件,故ConsumeQueue文件夹的组织方式为topic/queue/file三层组织结构,具体存储路径为:$HOME/store/consumequeue/{topic}/{queueId}/{fileName}同样
ConsumeQueue文件采取 定长 设计,每一个条目共 20 个字节,分别为 8 字节的CommitLog物理偏移量、4 字节的消息长度、8 字节 Tag 的hashcode,单个文件由 30W 个条目组成,可以像数组一样随机访问每一个条目,每个ConsumeQueue文件大小约 5.72MB -
IndexFile
IndexFile 提供了一种可以通过 key 或时间区间来查询消息的方法
整个消息存储的结构,最主要的就是 CommitLog 和 ConsumeQueue ,而 ConsumeQueue 可以大概理解为 Topic 中的队列

RocketMQ 采用的是 混合型的存储结构 ,即为 Broker 单个实例下所有的队列共用一个日志数据文件来存储消息,而同样高并发的 Kafka 中会为每个 Topic 分配一个存储文件
RocketMQ 这么做的原因是 提高数据的写入效率 ,不分 Topic 意味着有更大的几率获取 成批 的消息进行数据写入,但是读取消息的时候需要遍历整个大文件,非常耗时
所以在 RocketMQ 中又使用了 ConsumeQueue 作为每个队列的索引文件来 提升读取消息的效率。可以直接根据队列的消息序号,计算出索引的全局位置(索引序号 × 索引固定⻓度20),然后直接读取这条索引,再根据索引中记录的消息的全局位置,找到消息
大致的流程入下图所示:

- 生产者发送消息会指定 Topic、QueueId 和消息内容,
Broker收到之后直接 全部顺序存储到了 CommitLog Broker根据生产者指定的 Topic 和 QueueId 将这条消息本身在 CommitLog 的 offset、消息大小和 Tag 的 HASH 值存入对应的ConsumeQueue索引文件中- 每个队列中都保存了
ConsumeOffset(每个消费者组的消费位置),消费者拉取消息进行消费的时候只需要根据ConsumeOffset获取下一个未被消费的消息即可
☞ RocketMQ 的部署
部署特点
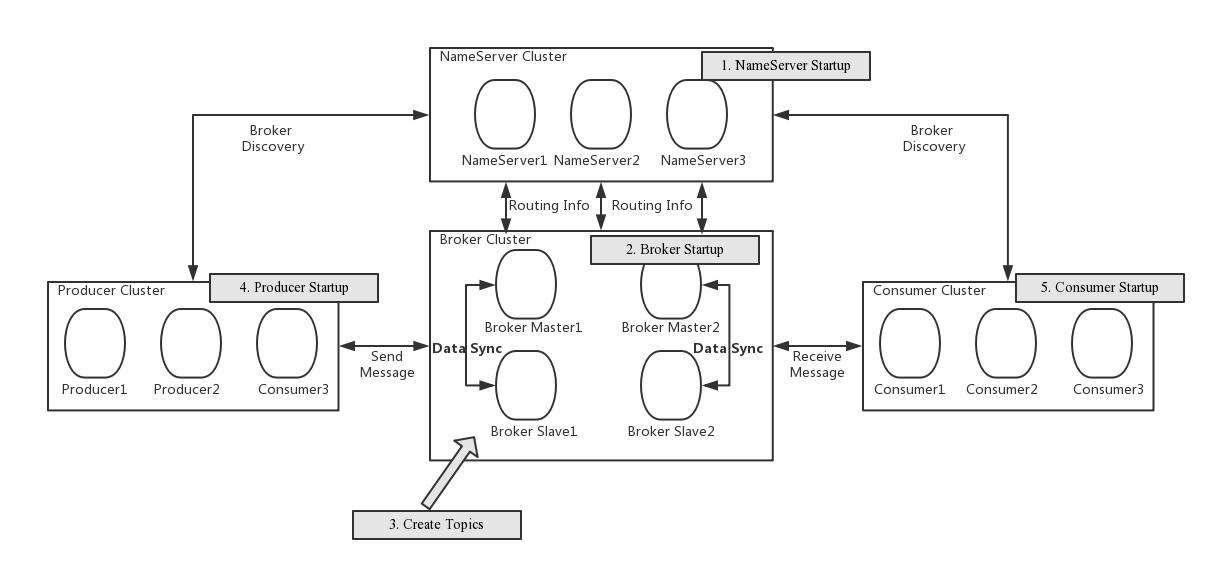
NameServer是一个几乎无状态节点,可集群部署,节点之间无任何信息同步Broker分为Master与Slave,一个Master可以对应多个Slave,但是一个Slave只能对应一个Master,Master与Slave的对应关系通过指定相同的BrokerName、不同的BrokerId来定义,BrokerId为 0 表示Master,非 0 表示Slave。Master也可以部署多个。每个Broker与NameServer集群中的所有节点建立长连接,定时注册Topic信息到所有NameServer。Producer与NameServer集群中的其中一个 随机 节点建立长连接,定期从NameServer获取Topic路由信息,并向提供Topic服务的Master建立长连接,且定时向Master发送心跳。Producer完全无状态,可集群部署Consumer与NameServer集群中的其中一个 随机 节点建立长连接,定期从NameServer获取Topic路由信息,并向提供Topic服务的Master、Slave建立长连接,且定时向Master、Slave发送心跳。Consumer既可以从Master订阅消息,也可以从Slave订阅消息,在向Master拉取消息时,Master服务器会根据拉取偏移量与最大偏移量的距离(判断是否读老消息),以及从服务器是否可读等因素建议下一次是从Master还是Slave拉取
集群工作方式
- 启动
NameServer后监听端口,等待Broker、Producer、Consumer连上来,相当于一个路由控制中心 Broker启动,跟所有的NameServer保持长连接,定时发送心跳包。心跳包中包含当前Broker信息(IP + 端口等)以及存储所有Topic信息。注册成功后,NameServer集群中就有Topic跟Broker的映射关系- 收发消息前,先创建
Topic,创建Topic时需要指定该Topic要存储在哪些Broker上,也可以在发送消息时自动创建Topic Producer发送消息,启动时先跟NameServer集群中的其中一台建立长连接,并从NameServer中获取当前发送的Topic存在哪些Broker上,轮询从队列列表中选择一个队列,然后与队列所在的Broker建立长连接从而向Broker发消息Consumer跟Producer类似,跟其中一台NameServer建立长连接,获取当前订阅Topic存在哪些Broker上,然后直接跟Broker建立连接通道,开始消费
💐 鸣谢
消息队列扫盲 👍